
10 مرداد 1405
برگزاری نخستین رویداد رقابتی هوش مصنوعی ایران در «ایرانداک»
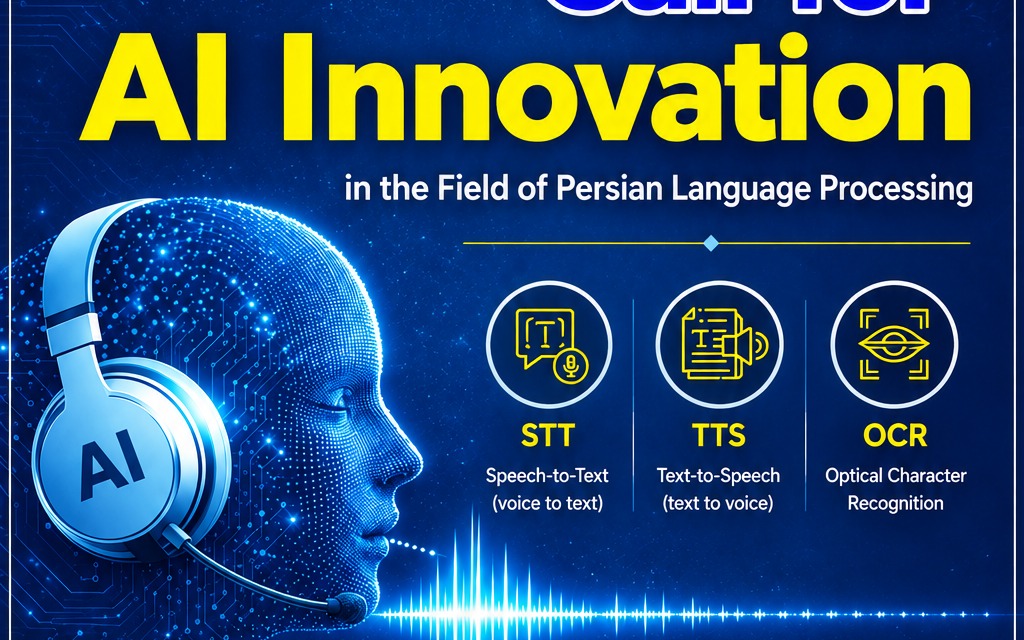
پژوهشگاه علوم و فناوری اطلاعات ایران (ایرانداک)، نخستین رویداد رقابتی هوش مصنوعی کشور را با تمرکز بر پردازش زبان فارسی برگزار میکند.
به گزارش گروه علمی ایرنا به نقل از روابط عمومی پژوهشگاه علوم و فناوری اطلاعات ایران، با گسترش سریع هوش مصنوعی، نیاز به پردازش دقیق و بومی زبان فارسی بیش از هر زمان دیگری احساس میشود. اگرچه مدلهای جهانی هوش مصنوعی به پیشرفتهای چشمگیری دست یافتهاند، اما در مواجهه با چالشهای خاص زبان فارسی و همچنین الزامات امنیتی سازمانها با محدودیتهایی روبهرو هستند.
این رویداد با هدف شناسایی و حمایت از تیمهای نخبهای طراحی شده است که محصولات آماده یا نیمهآمادهای در حوزههای «تبدیل گفتار به متن» (STT)، «تبدیل متن به گفتار» (TTS) و «بازشناسی نوری نویسهها» (OCR) توسعه دادهاند.
با توجه به توانمندیهای پژوهشگاه در حوزه هوش مصنوعی، برگزاری این رویداد میتواند گامی مؤثر در جهت تحول و معرفی ایرانداک به عنوان یکی از قطبهای پیشرو کشور در توسعه هوش مصنوعی بومی باشد.
اهداف رویداد:
۱. شناسایی و جذب هدفمند تیمهای فناور: کشف و بهکارگیری سریع تیمهای نخبه و استارتاپهایی که از مرحله ایده عبور کرده و دارای محصول اولیه (MVP) یا محصول نیمهآماده در حوزههای STT، TTS و OCR زبان فارسی هستند.
۲. اتصال پژوهش به صنعت: پر کردن شکاف میان تحقیقات علمی دانشگاهی و نیازهای واقعی بازار، و هدایت توانمندیهای پژوهشی به سمت توسعه راهکارهای کاربردی و بومی.
۳. توسعه مجموعهدادههای معیار (Benchmark): ایجاد و استانداردسازی مجموعهدادههای بومی در پژوهشگاه برای ارزیابی دقیق و قابلاعتماد مدلهای هوش مصنوعی در سطح کشور.
مراحل اجرایی (مدل ارزیابی و استقرار سریع):
- فاز ۱ (آمادهسازی پیش از رویداد): تدوین معیارهای ارزیابی تجاری و آمادهسازی مجموعهدادههای آزمون توسط کمیته علمی، به همراه ثبتنام تیمها و غربالگری اولیه.
- فاز ۲ (ارائه از راه دور): تیمها به صورت مجازی ارائه خواهند داشت و الگوریتمهای آنها مورد آزمون قرار میگیرد که منجر به انتخاب اولیه تیمهای برتر خواهد شد.
- فاز ۳ (ارزیابی فنی دقیق): الگوریتمهای هر تیم بر روی دادههای آزمون پژوهشگاه اجرا میشود. امتیازات فنی و تجاری تجمیع شده و ۳ تا ۵ تیم برتر انتخاب خواهند شد.
- فاز ۴ (رویداد نهایی و جذب): تیمهای منتخب در رویداد نهایی شرکت کرده، دموی محصولات خود را به هیئت داوران ارائه میدهند و به عنوان فینالیست معرفی میشوند. تیمهای برگزیده وارد مراحل انعقاد قرارداد، دریافت سرمایه اولیه (Seed Funding) و استقرار در مرکز رشد خواهند شد.
ثبتنام برای این رویداد از ابتدای آگوست ۲۰۲۶ (مرداد ۱۴۰۵) آغاز شده است و اطلاعات تکمیلی در نشانی زیر قابل دسترس است:
اخبار مرتبط


نظرات
۰ دیدگاه
پربازدیدترین خبر

۰ کامنت